9월 22일부터 24일까지, AI가 인프라 코드를 바꾸고, 긴 에이전트 대화의 입력 비용을 낮추고, 생명과학 데이터에서 연구 후보를 고른다는 발표가 이어졌다. 문장만 놓고 보면 모두 “AI가 더 많은 일을 한다”는 이야기처럼 보인다.
공식 발표를 따라가 보니 셋의 경계는 꽤 달랐다. GKE 도구는 코드를 바꾸되 PR에서 멈추고, GPT-6 캐시는 재사용에 실패한 이유를 보여 준다. ART 연구에서 AI가 한 일은 효소의 기능을 밝히는 것이 아니라 실험 후보를 좁히는 것이었다.
세 발표 모두 직접 적용하거나 재현한 결과가 아니라 공식 자료를 바탕으로 정리했다. 그래서 무엇이 추가됐는지보다, 발표가 책임지지 않는 범위를 함께 적었다.
2026년 9월 22~29일 공식 발표 가운데 서로 다른 경계를 보여 준 세 가지를 골랐다.
EKS에서 GKE로 옮길 때, AI의 역할은 PR을 만들기까지다
Google Cloud는 9월 24일 GKE agentic migration을 오픈소스로 공개했다. EKS 환경의 Terraform과 Kubernetes manifest를 읽고, GKE landing zone에 맞는 Terraform·YAML을 생성하는 agent plugin이다. 로컬 MCP server와 agent skills로 구성되며 결과는 Git 저장소의 pull request로 제출된다.
변환 범위는 단순한 리소스 이름 변경보다 넓다. 발표문은 AWS IRSA를 Workload Identity로, ALB ingress를 Gateway API로, Karpenter node claim을 GKE Node Auto Provisioning 또는 Custom Compute Classes로 옮기는 예를 든다. 생성된 결과는 terraform validate와 manifest contract 같은 결정적 검증을 거친다. 리뷰와 승인은 사람이 맡고, 배포는 기존 CI/CD 절차에서 진행된다.
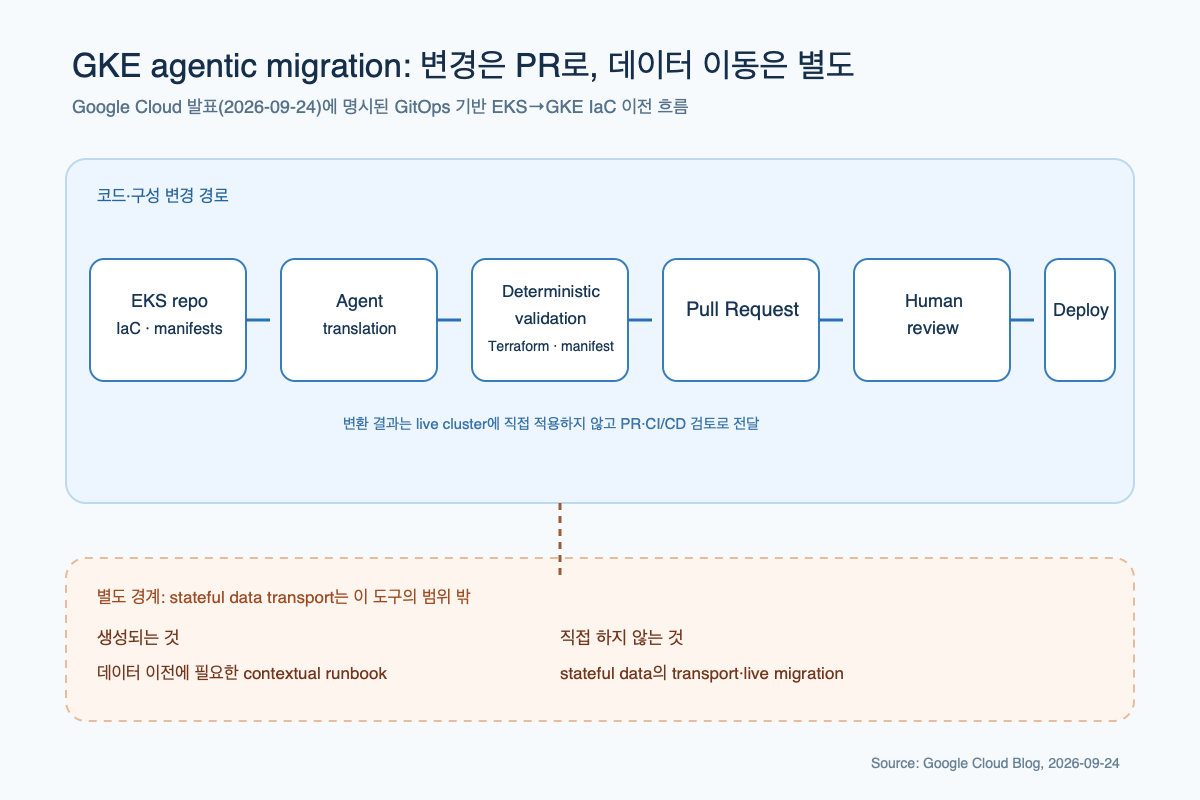
AI가 만든 구성 변경은 PR과 사람 검토를 거치며, stateful data 이동은 이 도구가 직접 수행하지 않는다. 출처: Google Cloud 공식 발표, 2026-09-24.
여기까지가 Google Cloud가 발표한 동작이다. 이 구성이 의미 있는 이유는 AI가 만든 IaC를 live cluster에 바로 적용하지 않고 기존 GitOps 흐름에 넣기 때문이다. 변경 내역을 diff로 보고 CI에서 검사하며 승인 시점을 정할 수 있다. 일반 LLM에 YAML 변환을 한 번 요청하는 것과 달리, 결과를 검토 가능한 변경 단위로 남긴다는 점이 실제 차이다.
적용 대상도 꽤 선명하다. 이미 Terraform과 Kubernetes manifest를 Git으로 관리하고 있으며 EKS에서 GKE로의 이전을 검토하는 플랫폼·SRE 팀에 맞는다. 반대로 Kubernetes 배포 구성이 코드로 정리되어 있지 않거나, EKS 이외 환경에서 출발하거나, GKE가 목적지가 아니라면 발표된 범위에서 바로 얻을 수 있는 이점은 제한적이다.
가장 큰 경계는 stateful data다. 이 도구는 데이터 자체를 전송하지 않고 migration runbook만 만든다. 데이터 이전에는 Database Migration Service나 Storage Transfer Service 같은 별도 수단이 필요하다. 따라서 “클러스터 마이그레이션 자동화”를 애플리케이션과 데이터까지 한 번에 옮겨주는 기능으로 읽으면 안 된다.
공개 도구라는 이유만으로 바로 이전 계획에 넣기는 어렵다. 먼저 실제 저장소에서 만든 PR이 custom resource와 admission policy를 보존하는지 확인해야 한다. 트래픽·권한 모델, 데이터 cutover와 rollback은 이 도구 밖에서 별도로 이어 붙여야 한다.
GPT-6 prompt caching은 할인보다 cache miss의 이유를 보여준다
OpenAI는 9월 22일 GPT-6의 prompt caching 개선을 발표했다. 같은 instructions, tool definitions, 이전 대화처럼 공유되는 prefix를 반복 전송하는 에이전트가 주된 대상이다. 30분 안에 다시 사용되는 eligible shared prefix에 캐시가 적용되며, cached input token에는 최대 90% 할인이 적용된다고 밝혔다.
할인율만 보면 비용 발표처럼 보이지만, 개발자가 다룰 수 있는 변화는 관측 기능 쪽에 더 많다. Prompt Caching Dashboard에서는 cache hit rate와 cached·uncached input token 구성을 볼 수 있다. diagnostics는 model, tools, settings, input 가운데 무엇이 바뀌어 cache miss가 생겼는지와 영향을 받은 token 수를 반환한다.
명시적으로 재사용 경계를 정하는 cache breakpoint와 캐시를 미리 준비하는 prewarming도 추가됐다. 요청 단위로 reasoning effort를 바꿀 때는 configuration_update를 사용해 캐시를 유지할 수 있다. 필요한 tool만 allowed_tools로 허용하면 tool definition 전체를 자주 바꾸지 않고도 실행 범위를 조절할 수 있다는 설명도 함께 나왔다.
이 변화는 장시간 코딩 에이전트, 대화형 앱, 문서 생성처럼 큰 공통 context를 여러 요청에서 되쓰는 GPT-6 애플리케이션에 맞는다. 요청마다 지시문과 도구 정의가 크게 달라지거나 공유 prefix가 짧다면 캐시 최적화의 효과도 작을 수 있다.
여기서 최대 90% 할인은 전체 API 비용이 90% 줄어든다는 뜻이 아니다. 캐시 대상으로 인정된 input token 가격에만 적용된다.
게다가 30분이라는 시간 조건이 있다. model·tool·setting·input이 바뀌면 cache miss가 날 수 있고, 캐시 적중이 응답 품질이나 지연 시간 개선까지 보장하지도 않는다.
도입 전에는 기존 트래픽의 cache hit rate를 먼저 기준선으로 남기고, 배포 전후 diagnostics에서 miss 원인과 token 영향을 비교할 필요가 있다. breakpoint와 prewarming은 기본으로 켤 기능이라기보다, 재사용되는 prefix가 충분히 크고 호출 패턴이 확인된 뒤 평가할 선택지에 가깝다. 공식 발표의 할인 상한보다 각 서비스의 실제 cached input 비율이 비용 판단에 더 직접적인 숫자다.
950개 에이전트가 좁힌 것은 효소의 기능이 아니라 실험 후보였다
Anthropic은 9월 23일 Claude가 CRISPR 유사 반복 서열과 연관된 새로운 효소계 후보를 찾았다는 연구를 공개했다. 이름은 array-associated reverse transcriptases, 줄여서 ART다.
Anthropic의 설명에 따르면 약 950개의 Claude agent가 21시간 동안 2억 1천만 token을 사용해 DNA 데이터베이스를 탐색했다. 20만여 개 reverse transcriptase에서 약 3,500개 후보를 추리고, 상위 20개를 사람이 읽을 수 있는 보고서로 정리했다. 인간 연구자는 초기 prompt를 설계하고, 선정된 후보를 실험으로 확인하는 일을 맡았다.
이 수치는 Anthropic이 공개한 작업량이다. 같은 비용과 시간으로 다른 연구 문제에서도 같은 성과가 난다는 근거는 아니다. 결과 역시 동료 심사를 마친 확정된 발견이 아니라 공개된 preprint와 회사의 연구 설명에 근거한다.
특히 ART의 1차 기능은 아직 밝혀지지 않았다. CRISPR와 비슷한 반복 서열이 관찰됐다는 사실만으로 방어 기작이나 유전자 편집 응용을 확정할 수 없다. 이번 결과의 정확한 이름은 ‘발견 완료’보다 ‘검증할 후보 생성’에 가깝다.
그래서 적용 대상을 “AI가 생물학 연구를 대신하는 경우”로 넓혀 잡기 어렵다. 후보 공간이 크고, 데이터베이스 검색과 근거 비교를 병렬화할 수 있으며, 마지막에 전문가가 우선순위를 검토하고 실험할 수 있는 연구 문제에 더 가깝다. Anthropic은 연구실이 BSL-1과 BSL-2 범위만 다루고 인간 감염 병원체는 취급하지 않으며, 실제 실험은 인간 과학자가 수행한다고 밝혔다.
다음 확인점은 ART의 생물학적 기능과 재현성이다. 다른 연구팀의 검토와 후속 실험이 이어져야 후보의 의미와 응용 가능성을 말할 수 있다. 연구 운영 측면에서는 950개 에이전트가 만든 중간 가설과 탈락 근거를 어느 정도 추적할 수 있는지, 2억 1천만 token을 쓴 탐색이 기존 분석법과 비교해 어떤 추가 가치를 냈는지도 남아 있다.
발표보다 다음 증거를 기다리는 이유
이번 발표들에서 가장 쉽게 부풀려지는 단어는 ‘마이그레이션’, ‘90% 할인’, ‘발견’이었다. 실제 범위는 그보다 좁다. 데이터 이동은 별도 작업이고, 할인은 캐시된 input token에만 적용되며, ART는 아직 기능을 모르는 후보군이다.
그래서 판단은 각자의 다음 증거가 나온 뒤에 이어가면 된다. 지금은 생성된 PR, 실제 cache hit rate, 후속 실험 결과가 비어 있다. 발표가 채우지 않은 칸을 남겨 두는 것이 이번 기록의 결론이다.
공식 자료
- Google Cloud: GKE agentic migration — 2026-09-24
- OpenAI: Better prompt caching for GPT-6 — 2026-09-22
- Anthropic: Claude discovers a novel enzyme system with CRISPR-like repeats — 2026-09-23
'AI' 카테고리의 다른 글
| AI로 긴 문서 용어 통일하기: 불일치 목록부터 치환 초안까지 (0) | 2026.10.01 |
|---|---|
| Gmail 별표 메일을 매일 Sheets 할 일로 모으기: 중복 없이 기록하는 Apps Script (0) | 2026.09.30 |
| 15분 오픈소스 5선 (0) | 2026.09.28 |
| AI 문서 초안이 어긋날 때 쓰는 5칸 요청서 (0) | 2026.09.24 |
| 배포 파이프라인에서 이번 주 바뀐 세 지점: Actions·npm·Bigtable (0) | 2026.09.22 |


댓글